資料庫 - 你需要速度? NATS Queue 是你正在找的
Blazing Fast Message Queue
Message Queue 這個議題我們探討了算滿多的
針對不同的場景你可以使用不同的技術
比方說如果你需要可以持久化資料的 MQ 或是可以重新 consume 你可能會選 Kafka
如果你需要的是複雜的路由控制,RabbitMQ 是個好選擇
可參考 資料庫 - 從 Apache Kafka 認識 Message Queue | Shawn Hsu
以及 資料庫 - 解耦助手 RabbitMQ | Shawn Hsu 都詳盡了講述了 Kafka, Rabbitmq 以及 Message Queue 的技術細節
但其實好像沒有人特別強調速度?
大部分的 use case 真的就直接 RabbitMQ 下去就能解了
真的只有極少數會需要處理速度非常快速的 Message Queue
像是 edge computing, AI agent to agent communication 或是高頻交易 遊戲那些
Introduction to NATS Queue
所以 NATS Queue 就是針對這種極端 use case 而存在的
Born to be Lightweight
是什麼讓 NATS Queue 能夠面對這種場景
主要是因為他極致輕量,把 NATS server 跑起來只需要一個 binary
所有額外的 configuration 比如說 JetStream 也是在同一個 server 上面進行設定,沒有額外的東西需要安裝
另外是,NATS 本身只做收發訊息,任何其他功能基本上都是不處理的
功能簡單而且他只把東西放在記憶體內所以他跑起來也輕
而最核心我認為讓他輕量的原因是他的協議
基本上他是自幹的一套協議
全部靠一個巨大的 switch case 去把需要的東西解出來(nats-server/server/parse.go#L137)
1
2
3
4
5
if c.state == SUB_ARG || c.state == UNSUB_ARG ||
    c.state == PUB_ARG || c.state == HPUB_ARG ||
    c.state == ASUB_ARG || c.state == AUSUB_ARG ||
    c.state == MSG_ARG || c.state == HMSG_ARG ||
    c.state == MINUS_ERR_ARG || c.state == CONNECT_ARG || c.state == INFO_ARG {
Connection
NATS connection 從頭到尾就是用同一條,所有的 publish/subscribe 的訊息都是走這個 long-live 的 TCP connection
然後每一則訊息都會上 tag 用以區分到底是哪個方向過來的這樣
How Message is Delivered
所以理解起來也就挺簡單的了
他… 就是 Message Queue
NATS Queue 本身是 publisher subscriber pattern
publisher 會送資料到所謂的 Subjects, Subjects 就是一個 name channel, 一個可以讓 publisher/subscriber 找到彼此的名字
然後 subscriber 從 Subjects 那邊拿到 copy(每個 subscriber 都會拿到自己獨立一份 copy)
有關 publisher subscriber 可以參考 設計模式 101 - Observer Pattern | Shawn Hsu
NATS Queue 是
at most once delivery
No Subscriber?
但這邊有個很重要的東西需要注意
NATS Queue 是屬於 fire and forget
意思是 publisher 不會等 ACK,並且如果訊息過來的當下沒有 subscriber
你的訊息會 被 丟 掉
NATS 並不會嘗試 retry,也偵測不到 duplicate message
甚至不保證訊息抵達的順序
Interest Graph
那 NATS 他是透過 interest graph 去記錄說誰對 Subjects 有興趣
他是一個 in-memory data structure
所以他的操作都滿快的
當訊息到來的時候,server 會去看 interest graph 找出要寄給誰副本
注意到,只有在收到訊息當下才會去解析,這也就是為什麼當沒有 subscriber 的時候你的訊息會被丟掉(c.f. No Subscriber?)
Subjects
我們已經知道 Subjects 本質上就是一個可以讓 publisher/subscriber 找到彼此的 named channel
而 Subjects 本身幾乎是零成本的
因為重點是看 Interest Graph,你想哦,是不是只有在有 subscriber 的情況下東西才會動
也就是說,如果你的 Subjects 沒有任何人訂閱,這對 server 完全沒差
你也不用去 manage Subjects,就不用去刪除它 建立他 之類的
Queue Groups
那有沒有什麼辦法讓他變成不要 fan out 呢?(他是 publisher subscriber pattern 嘛,所以預設就會是 fan out)
你可以設定 Queue Groups,server 會把所有的 subscriber 視為是相同的 logical group
剩下的 NATS Queue 就會自己幫你選一個 random subscriber 發送訊息
注意到 Queue Groups 選 subscriber 的選法可能是不公平的,他不像 round robin 那樣有保證每個人都有機會
也因為
at most once delivery, 所以如果訊息送出去,subscriber 掛了,他是不會重送的
Request-Reply
所以本質上 NATS Queue 他是同步的 Message Queue(因為 fire and forget, 訊息之後到不會重送)
幸好! 有個辦法可以把它變成非同步的,也就是說 publisher 送完訊息之後他可以等 subscriber 回覆訊息給妳
稱為 Request-Reply
Request-reply isn’t a new protocol; it’s the pub/sub you already know, used twice.
本質上就是 publisher/subscriber 都訂閱相同的 Subjects
跟上面講的不同的是,在沒有 subscriber 的模式下 Request-Reply 是會回錯誤的
講到這你應該跟我一樣有個疑問
都用同一個 Subjects 他不會拿到自己發送的訊息嗎?
Request-Reply 他在 Subjects 的基礎上做了一點加工
NATS 建立了一個特殊的 private reply subject,這個特殊的 subject 的開頭是 _INBOX.(他是保留字)
針對每個 connection 他是 _INBOX.<connection>.<random-text> 的形式
publisher/subscriber 都是訂閱 _INBOX.<connection>.* 這個 Subject
那… 東西要怎麼正確的走,是靠後面那個 random-text
每一次送訊息他都會帶一個資訊說,”你回覆的時候請把資訊丟到 _INBOX.<connection>.<my-random-text>”
然後對方回給你也會帶一個 “你回覆的時候請把資訊丟到 _INBOX.<connection>.<your-random-text>”
因為訂閱的 subject 是 wildcard 的形式,所以東西都會正確的回來,最後再送到正確的人的手上
JetStream
如果說純粹的速度對你來說不重要,穩定才是
那麼 JetStream 是完全體的最後一塊拼圖
JetStream 是 NATS 的一個內建的子系統,他能夠把原本 NATS Queue 陽春的功能附魔
JetStream 可以把訊息 preserve 起來,提供了類似 Kafka 重新讀取訊息的功能
所以原本的 at most once 在這裡變成 at least once
How Stream Works
publisher 一樣是直接跟 Subjects 互動,你的訊息一樣是送到 Subjects
不同的是,丟到 Subjects 之後 server 會把訊息加到 Stream 上面
Stream的 persistent layer 可以選 memory 或是 disk
一個 Subjects 只會 bind 到一個 Stream 上面
你沒辦法把多個 Stream 接上相同的 Subjects
然後當你把訊息丟給 server 之後,server 會回一個 ACK 給你表示說哦我已經把訊息存起來了 這樣,稱為 PubAck
PubAck不代表 consumer 已經拿到訊息,只代表存好了
然後 consume 訊息這件事情就稍稍有點不同的
subscriber 實際上是連到所謂的 consumer, consumer 是一個存在在 server 上面的 object
他負責儲存你讀取的進度那些,所以你的 client 斷線再重聯 offset 依然會被保留住(因為他是存在 server 上的)
拿訊息有分
- fetch: 一次拿 n 個訊息
- consume: 一次拿一個訊息
並且 consume 其實可以有 pull-based 以及 push-based 兩種
但滿明顯的是官方文件完全沒有提到 push-based 的方法,僅有在 GitHub 找到相關文件
並且 nack 的範例程式碼也有用 push-based,應該算還支援的狀態吧
Retention Policies
那存在 Stream 裡面的訊息哪時候會不見
在 NATS 裡面有三種模式
Limits: 預設模式,看是 max age, max msgs 還是 max bytesInterest: 這個模式就是誰還想看這則訊息,沒人就刪WorkQueue: 當你 ACK 訊息之後他就會移除
適用情境就是
- 比方說 Log 這種就適合用
Limits - 每個 consumer 都必須要處理的資訊可以使用
Interest - 任務式的,
WorkQueue就滿適合的
Acknowledgement
資料庫 - 解耦助手 RabbitMQ | Shawn Hsu 裡面我們講了為什麼會需要 ACK
最主要的目的就是避免 auto ACK 造成的問題,就是你可能拿了訊息但是 consumer 掛了,因為訊息已經被 ACK 所以你的 consumer 沒辦法再重新處理
而 NATS 也有一模一樣的機制
不過其實這種也會有問題
他只保證了 client 不會掉訊息,他不保證 server 收得到 ACK(因為是 fire-and-forget)
所以 NATS 有這麼個東西叫做 Double ack
簡單來說,就是 client 送 ACK 給 server 會等待確認
他的設計思路就是我啥都要確認,那當然這樣會帶來一些 overhead
像 RabbitMQ 這種為了避免類似狀況,我們在設計 consumer handler 的時候就都會是 idempotent 的(處理一次跟處理很多次結果都是一樣的)
PubAck
PubAck 裡面有三個東西
- stream: 就是你的訊息是存在哪個 stream 裡面
- sequence: 訊息的編號,方便你之後可以重新讀取該訊息
- duplicate: 是新的還是重複的舊的訊息
Run NATS
NATS 官方有提供滿多安裝選項的,Docker, Homebrew 甚至是 curl 安裝 script 都有
1
2
3
4
5
6
$ docker run -p 4222:4222 -p 8222:8222 nats:latest
// or
$ brew install nats-server
// or
$ curl -sf https://binaries.nats.dev/nats-io/nats-server/v2@latest | sh
$ sudo mv nats-server /usr/local/bin/
不過我還是喜歡用 Helm Chart 的方式,這一樣是官方給的,有兩種
- 純 NATS 的 https://github.com/nats-io/k8s
- 各種 Controller 包在裡面的 https://github.com/nats-io/nack
我選擇各種 Controller 包在裡面的 nack
nack
我的環境
1
2
3
4
5
6
7
$ kubectl version
Client Version: v1.34.0
Kustomize Version: v5.7.1
Server Version: v1.34.8+k3s1

$ docker --version
Docker version 29.8.2, build 7fc2dff
Installation
就來安裝吧
1
2
3
4
5
6
7
8
9
10
$ helm repo add nats https://nats-io.github.io/k8s/helm/charts/
$ helm repo update

$ helm upgrade --install nats nats/nats \
  --set config.jetstream.enabled=true \
  --set config.jetstream.memoryStore.enabled=true \
  --set config.cluster.enabled=true --wait

$ helm upgrade --install nack nats/nack \
  --set jetstream.nats.url=nats://nats.default.svc.cluster.local:4222 --wait
Run the Example
照著官方的範例走一次
1
2
3
$ kubectl apply -f https://raw.githubusercontent.com/nats-io/nack/main/deploy/examples/stream.yml
$ kubectl apply -f https://raw.githubusercontent.com/nats-io/nack/main/deploy/examples/consumer_push.yml
$ kubectl apply -f https://raw.githubusercontent.com/nats-io/nack/main/deploy/examples/consumer_pull.yml
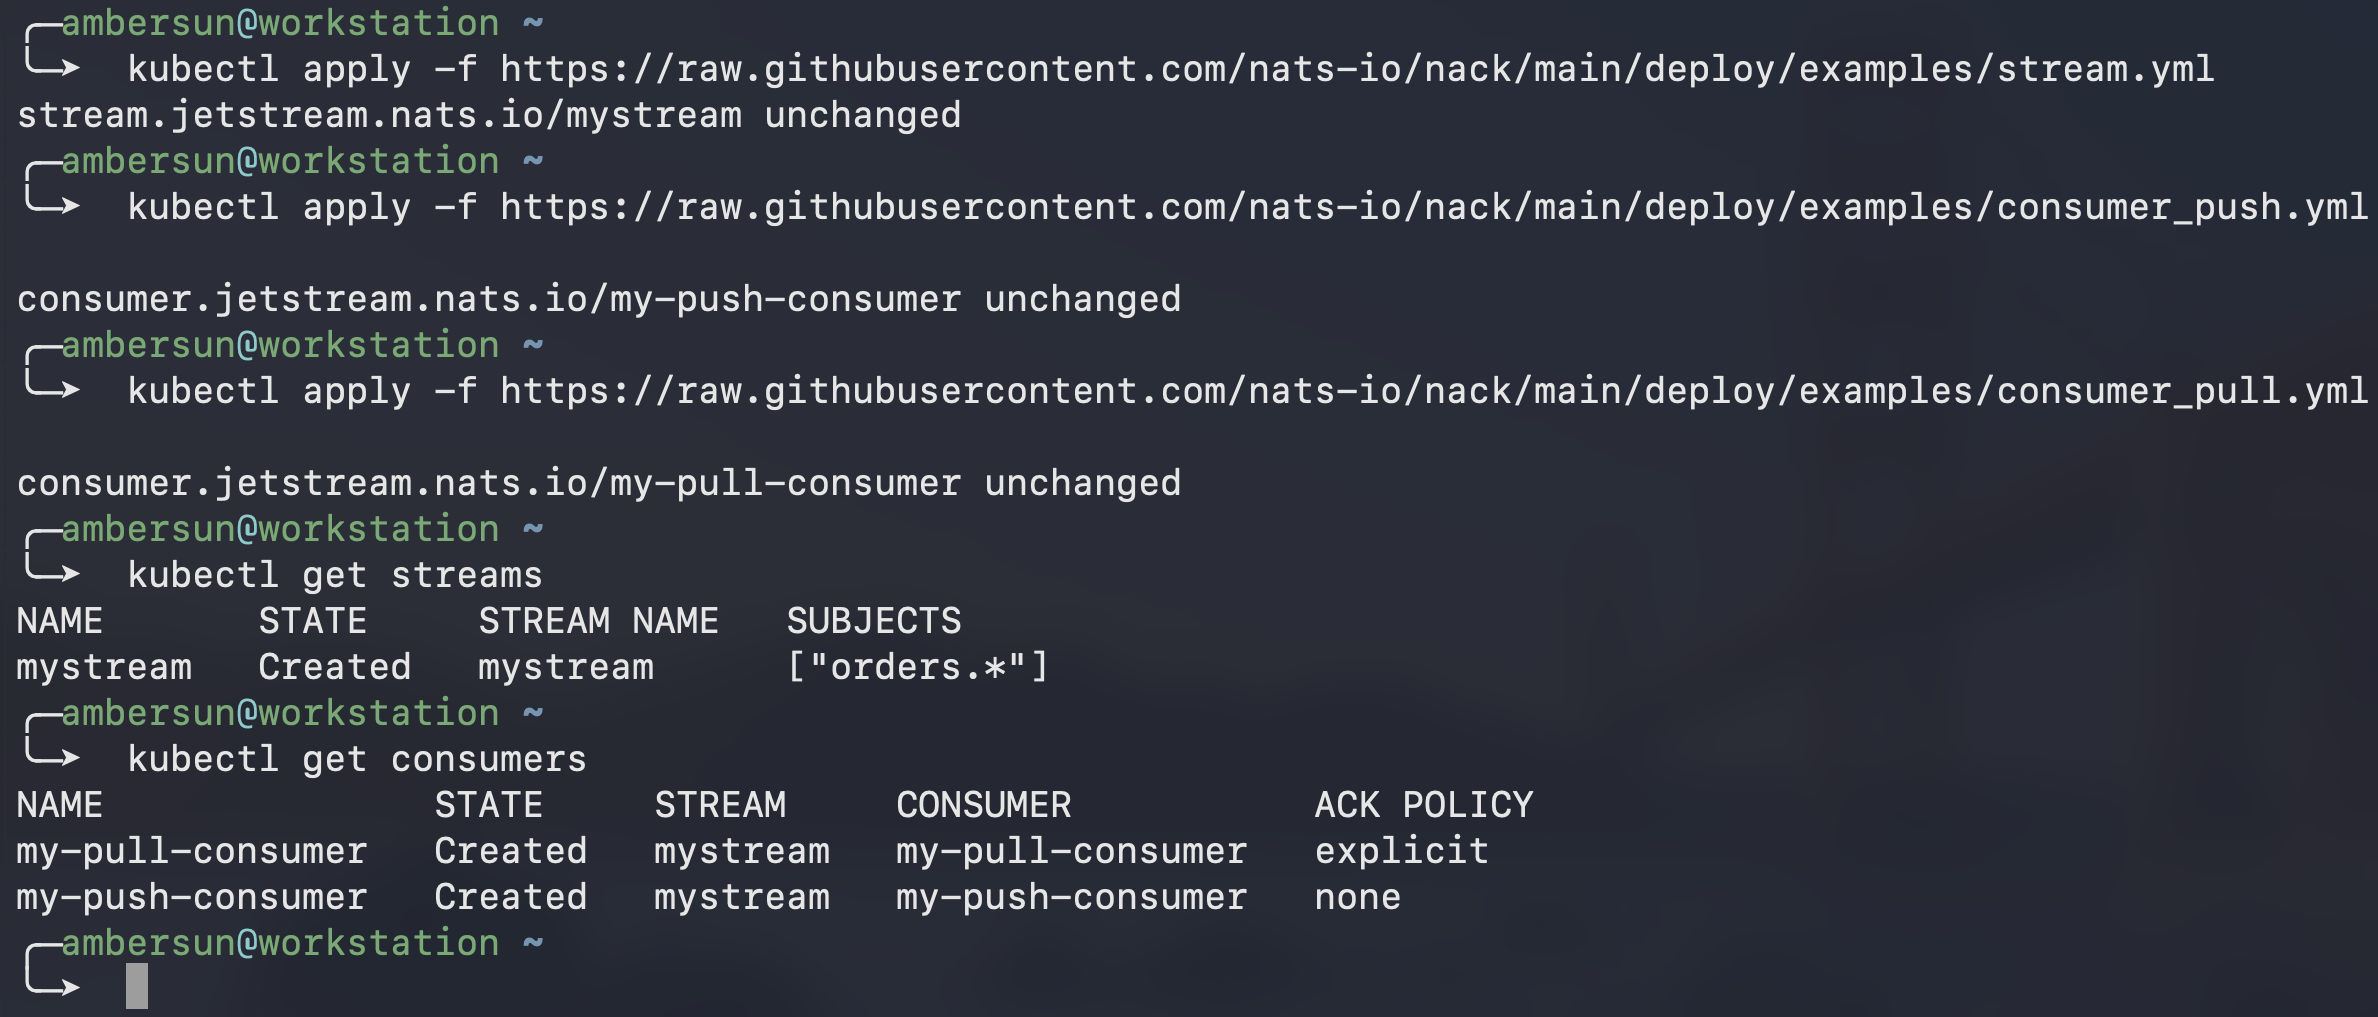
建立 stream, push-based 以及 pull-based consumer
就會像這樣
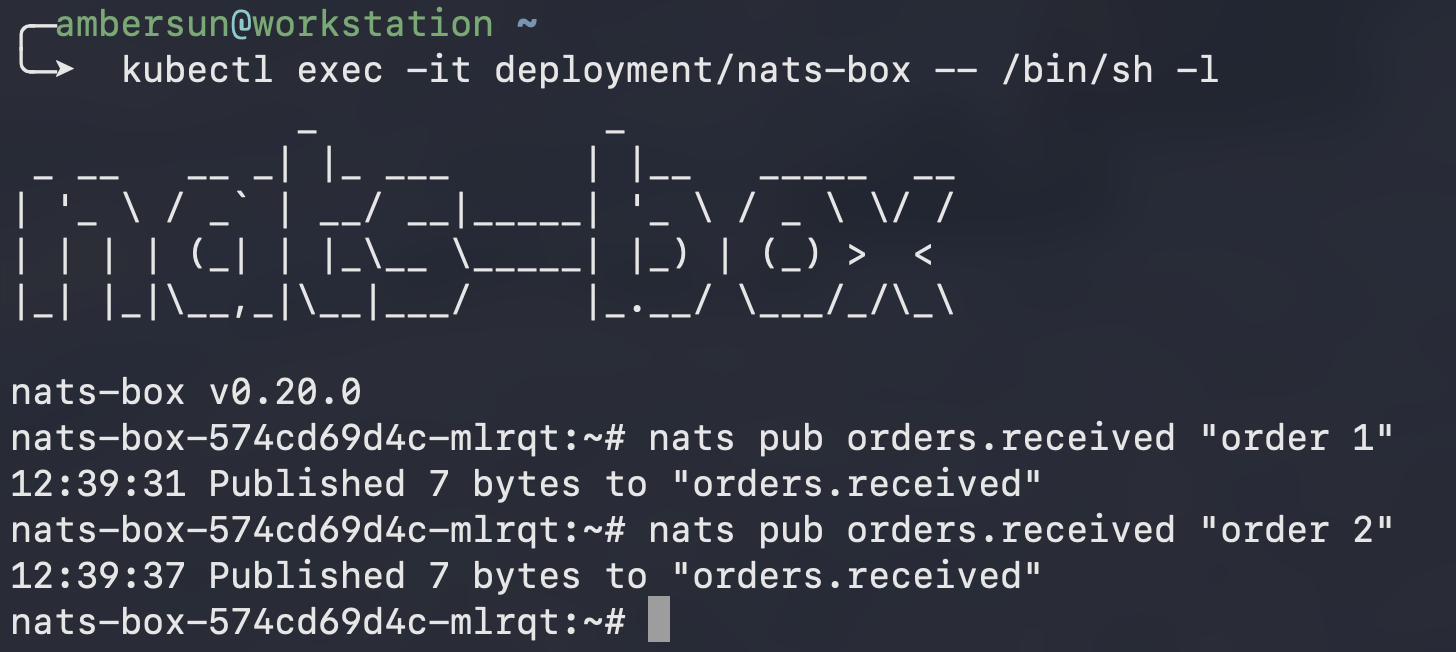
然後嘗試發送訊息
Pull-based Consumer
Consumer 的 CRD 滿簡單的,可參考 consumer_pull.yml
1
2
3
4
5
6
7
8
9
10
11
apiVersion: jetstream.nats.io/v1beta2
kind: Consumer
metadata:
  name: my-pull-consumer
spec:
  streamName: mystream
  durableName: my-pull-consumer
  deliverPolicy: all
  filterSubject: orders.received
  maxDeliver: 20
  ackPolicy: explicit
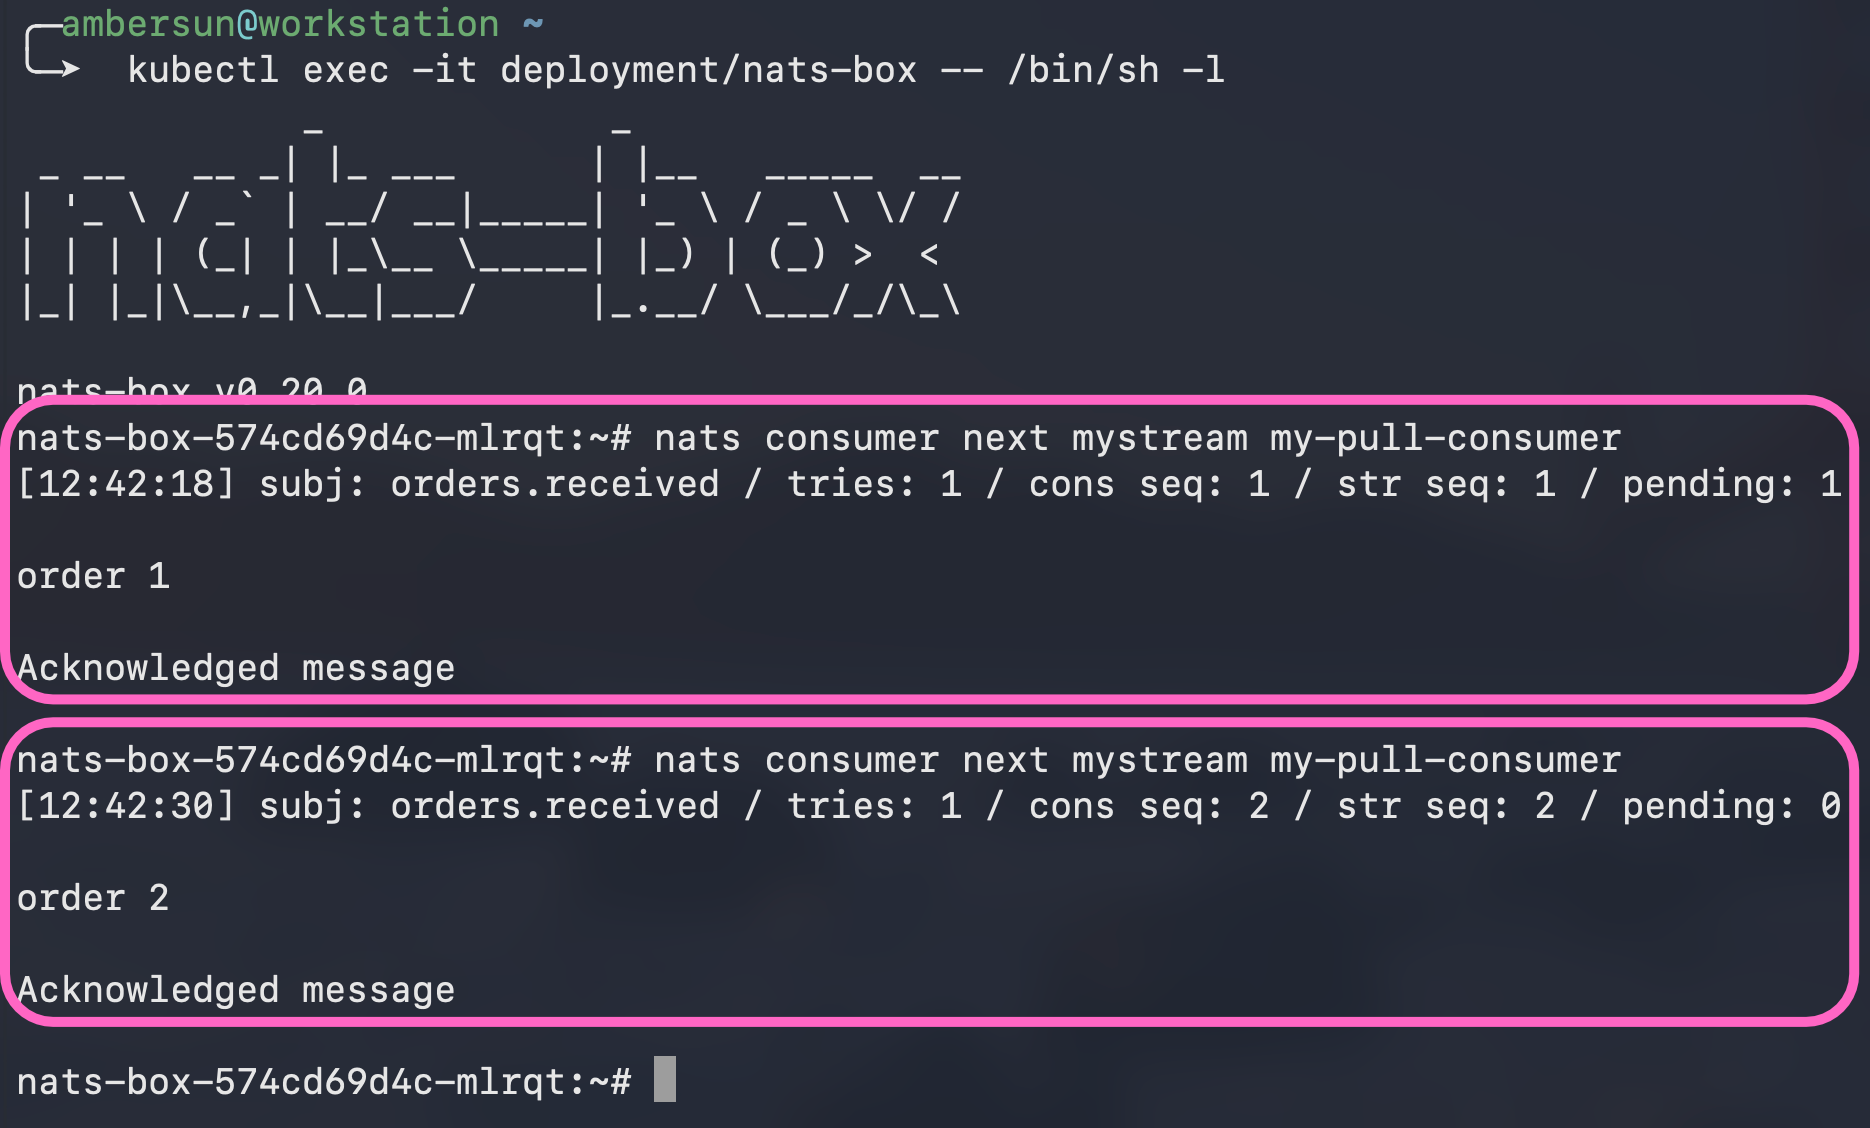
執行起來會像這樣,只有我手動要下一個他資料才會過來
Push-based Consumer
CRD 是用同一個不同參數設定的,可參考 consumer_push.yml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
apiVersion: jetstream.nats.io/v1beta2
kind: Consumer
metadata:
  name: my-push-consumer
spec:
  streamName: mystream
  durableName: my-push-consumer
  deliverSubject: my-push-consumer.orders
  deliverPolicy: last
  ackPolicy: none
  replayPolicy: instant
  description: my consumer description
  flowControl: true
  heartbeatInterval: 1s
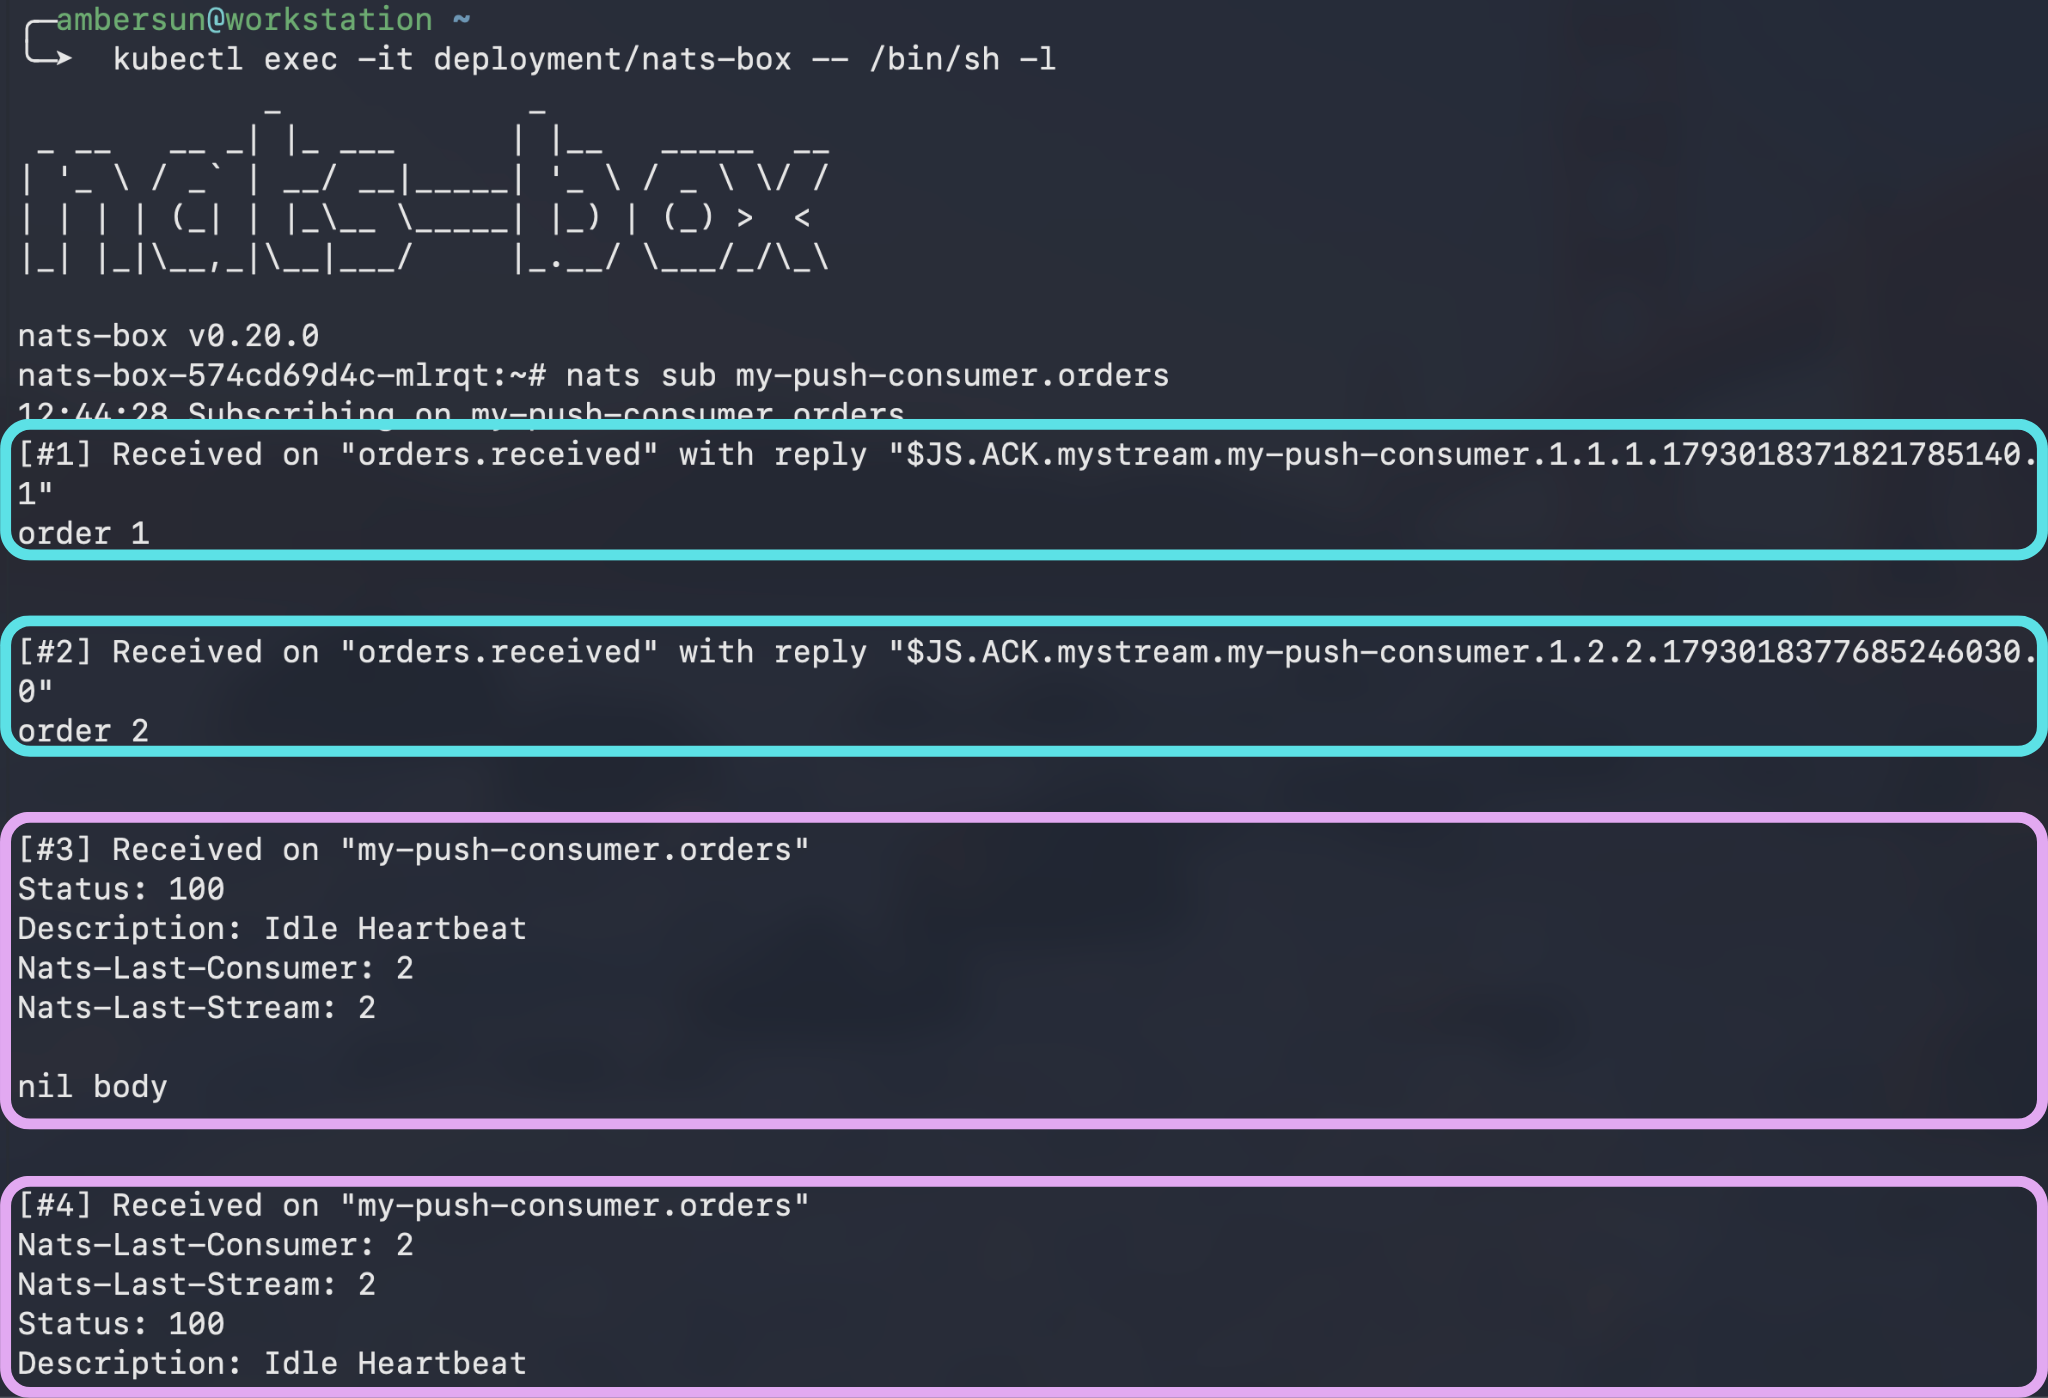
你用 push based consumer 實際上他資料會一直被推過來,圖片中你也可以看到他除了前兩個有收到
之後還有繼續,不過他停在 2 上面(Nats-Last-Consumer 跟 Nats-Last-Stream)
Leave a comment